

实现的成本极度降低,迭代速度加快
AI当前只能截帧,连续动态只能靠日志/多截几帧,成本高
时间、token效率AI不会评审程序员的prompt,可能会在错误的方向狂奔
浪费时间、浪费token游戏设计理论?
目前AI的能力还没达到这个层级发挥作用的阶段樱井政博AI的默认实现方式欠考虑运行时性能
游戏需要每帧tick · 每帧时间预算 = 1000 ÷ fps
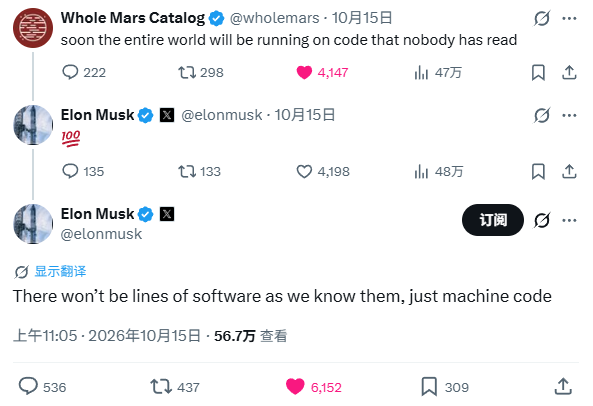
未来AI直接写机器码,编程语言直接消失?
“我想要……”
if (idea) {
create();
}
01001001
10100010
01010110



世界模型
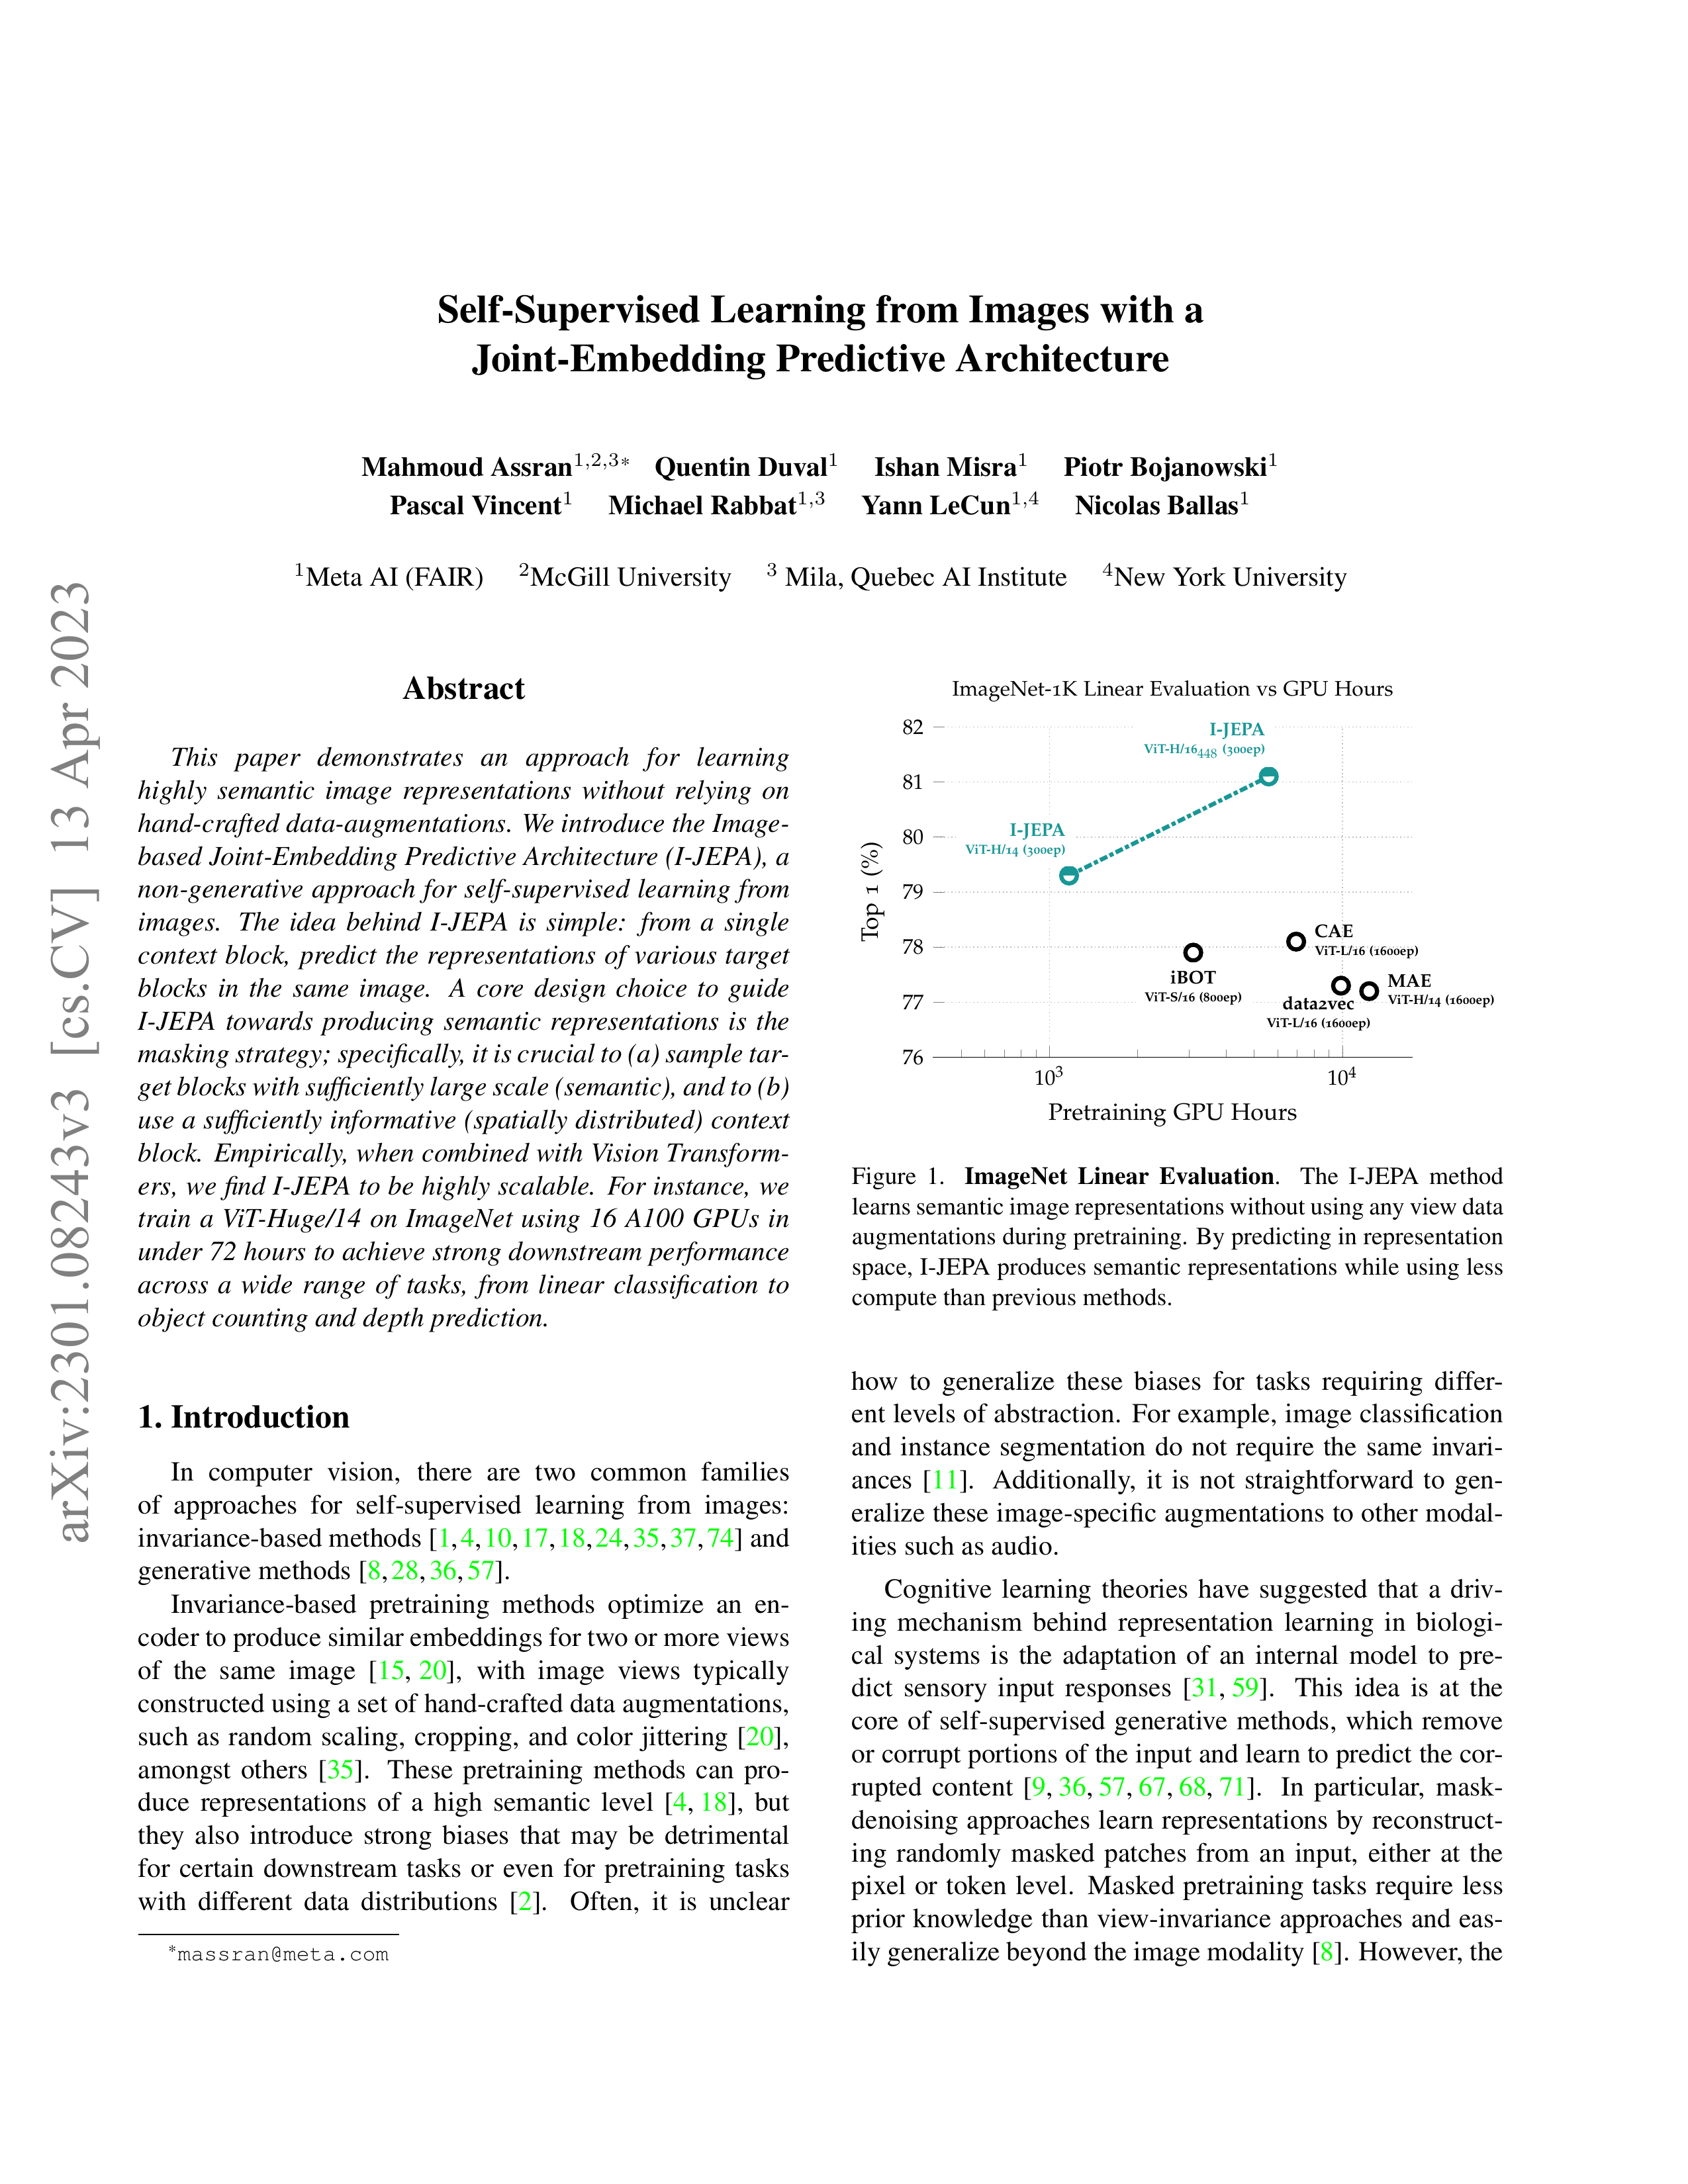
Self-Supervised Learning from Images
with a Joint-Embedding Predictive Architecture
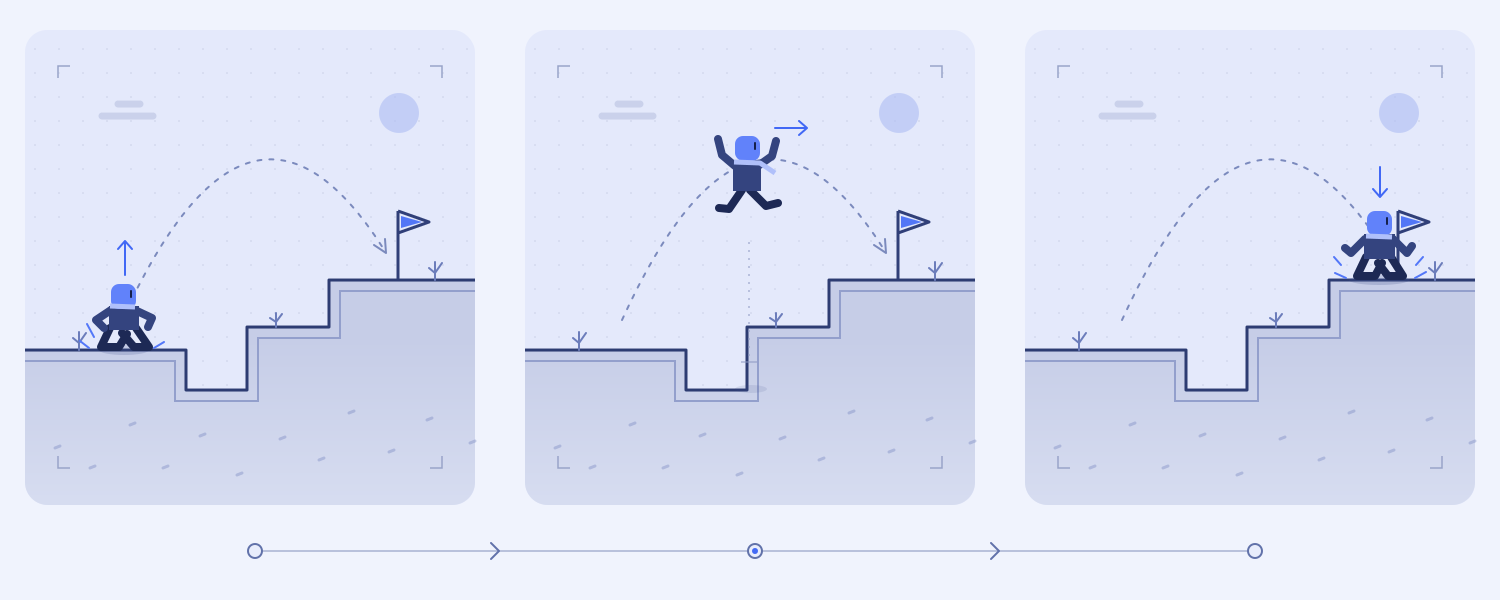
设计需要游戏理论Plan / Design
评价依赖审美甚至玩家个人经历
就像读书:
同样的文章,有的读者会勾起回忆而感激涕零,其他人却可能完全无感;
甚至同一个读者,在不同的人生阶段读,会有不同的感触。
Attention is All You Need!
Taste is all you need.
“微软最大的问题,
就是没有品味。”
“知道要做什么”、“知道做的思路”,
比“知道如何做”更重要。
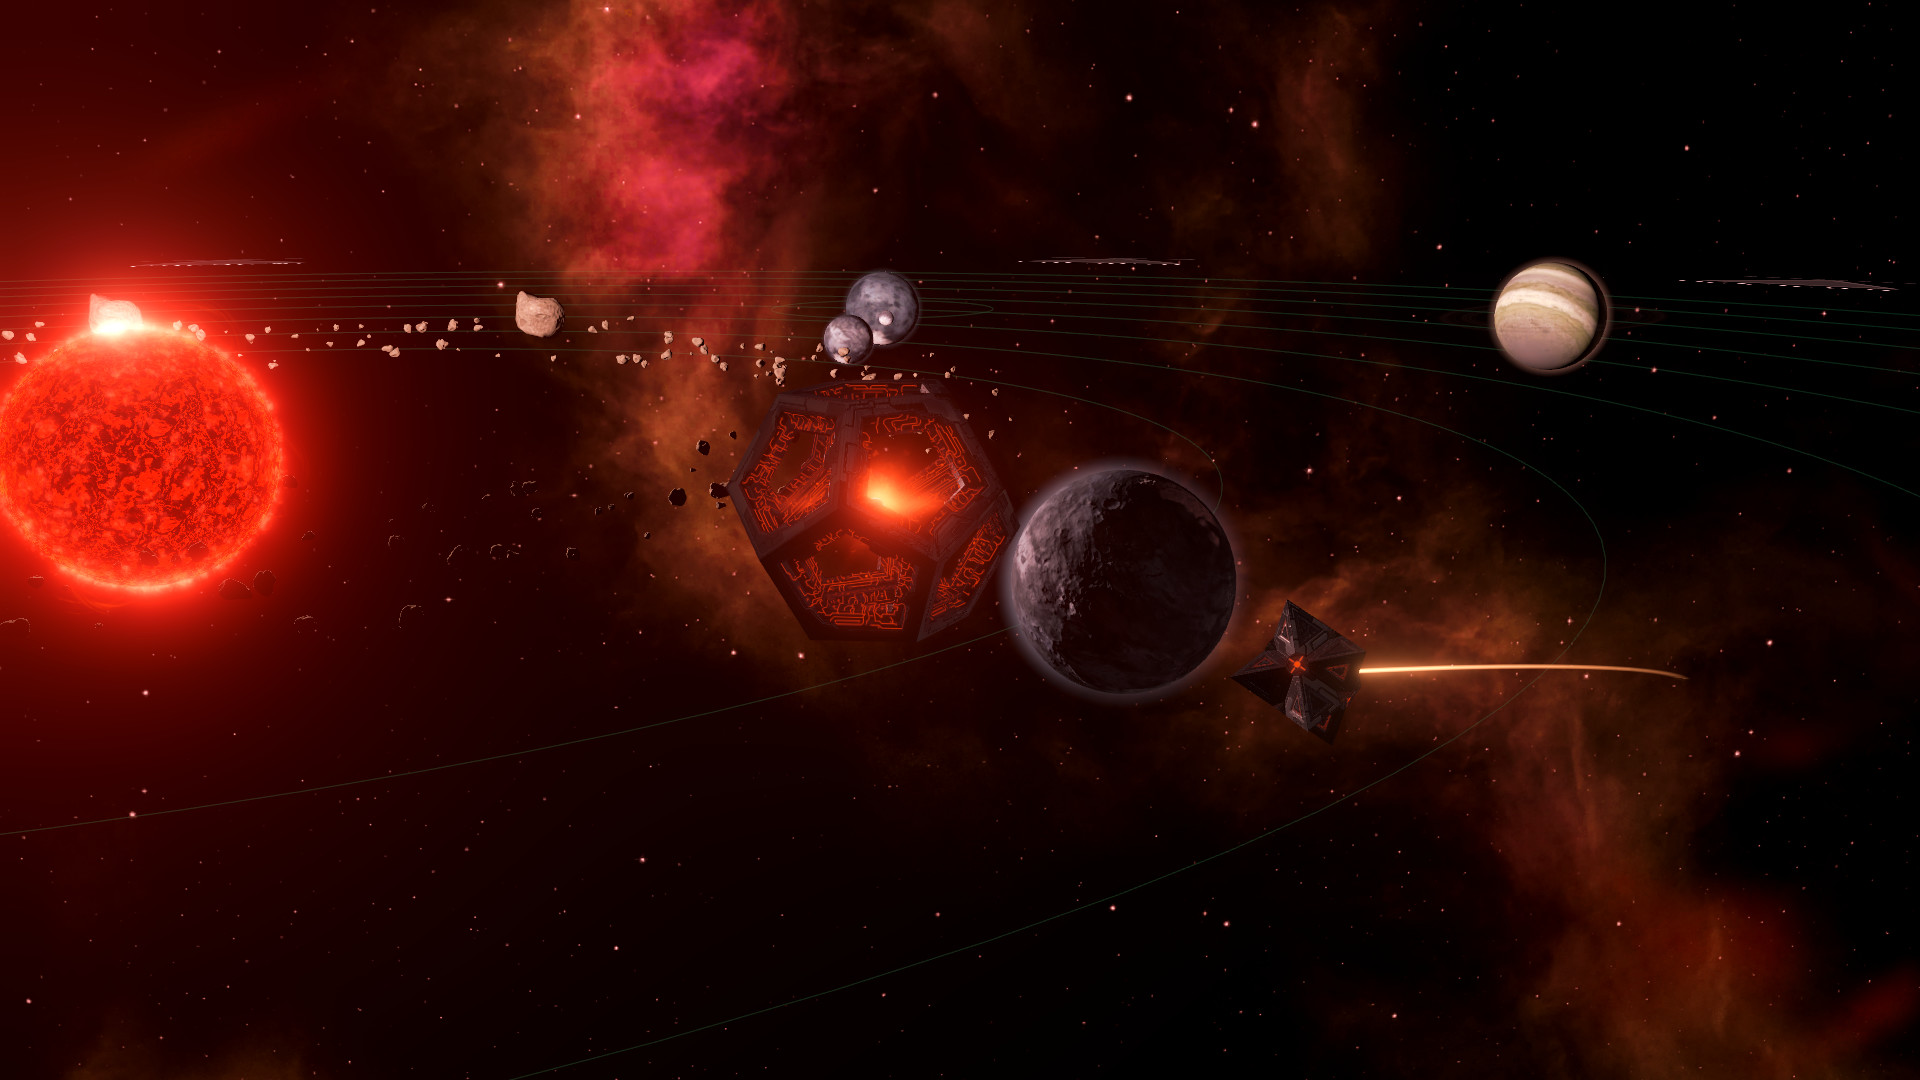

Stellaris · 群星
我对游戏界已经有了很深的理解
我对AI界仍需更多了解
人类也需要上下文输入
对于游戏任务
什么样的数据才能最有效地提高模型能力?
长程 · 复杂
游戏任务长程、复杂,单次rollout成本非常高
审美与游戏设计理论
不稳定!
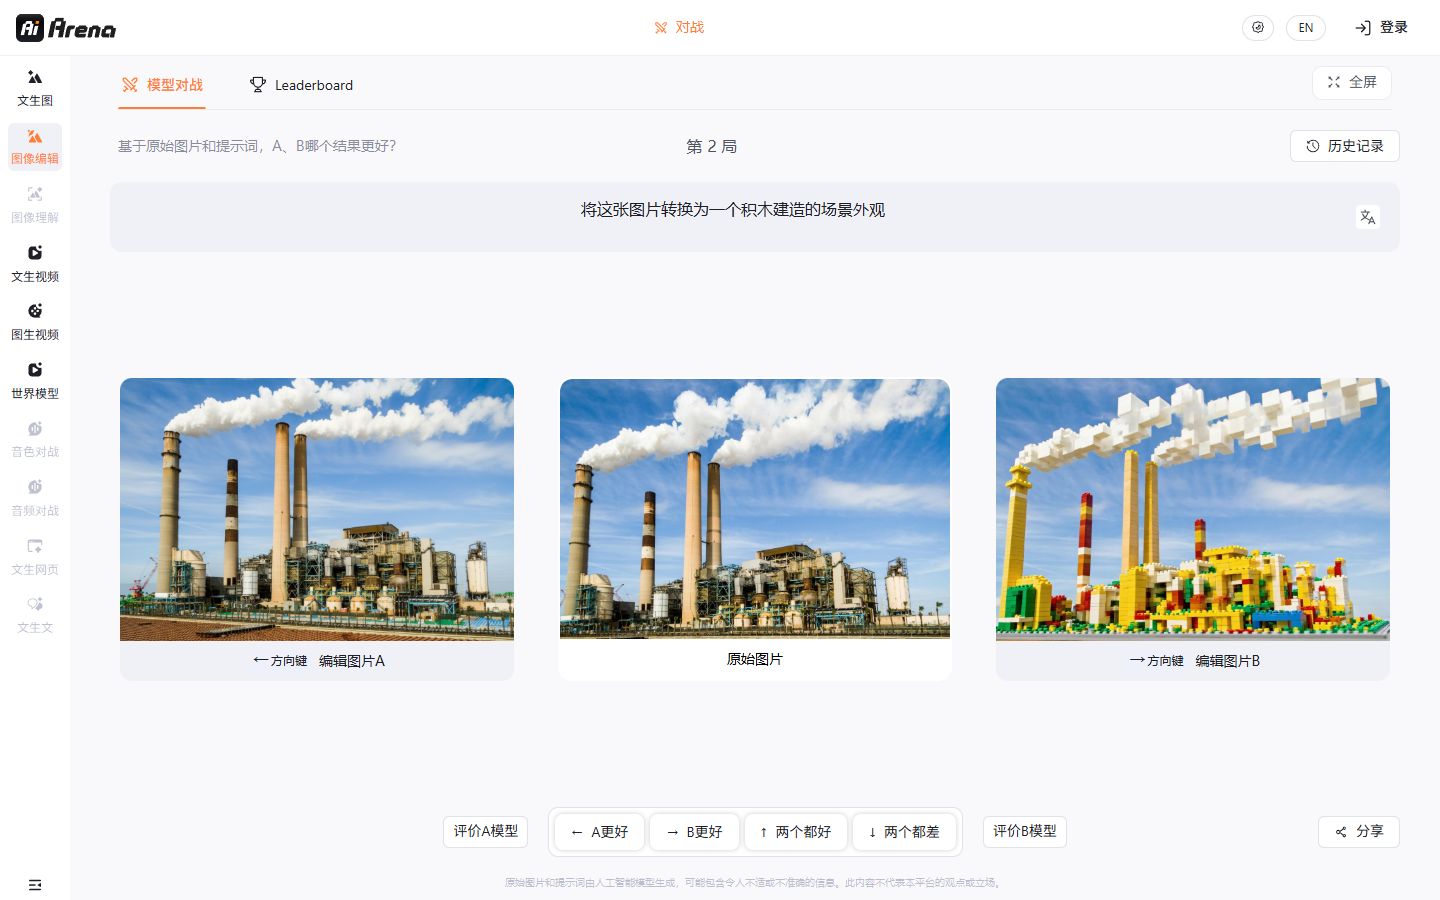
side by side 比较输出,人类选更好的
保序映射
f : (X, ≼) → (ℝ, ≤)
∀ x, y ∈ X,
x ≼ y ⇒ f(x) ≤ f(y)
原来的先后关系,映射后仍被保留。
循环胜负本身不是偏序;
单一分数无法保留全部严格胜负关系。
我觉得:
用AI领域的话来说,就是Label
There are only two hard things in Computer Science: cache invalidation and naming things.
-- Phil Karlton


西方有一套电影化工业化的
日本有一套明星制作人的
大陆有一套专注经济收益的
古法时代 · 游戏开发成本高、不开源
古法游戏项目相比其他数据集,数量上是凤毛麟角
年代 / 平台 / 付费方式
真实工业界的代码,
也不一定优质
古法游戏项目相比其他数据集,数量上是凤毛麟角

>10万亿 tokens
另有 >10亿张图像

>10万亿 tokens
另有 >10亿张图像
训练规模为官方披露下界。游戏数按 Gamalytic 的 Steam 份数估算:含免费获取,非全球付费销量;重制版等独立条目分别计数。单位不同,不作倍率比较。
GPT-6 摘要 §1.3 · Claude 摘要 §1.3 · Gamalytic 分布 / 排行 / 估算口径 · 查询:2026-10-17
程序员直接写汇编的时代
LDA #$01
STA $0200
各家自搓游戏引擎时代

业界趋于少数几个引擎的时代
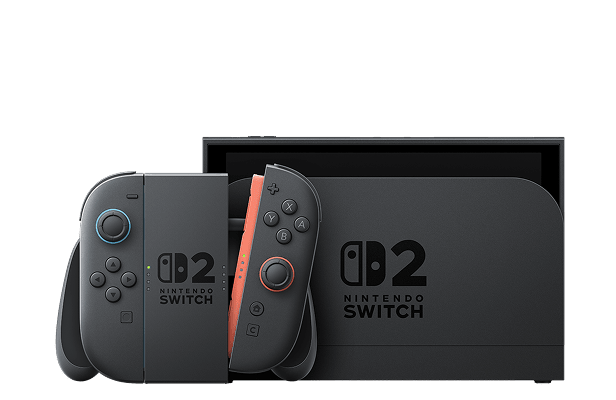
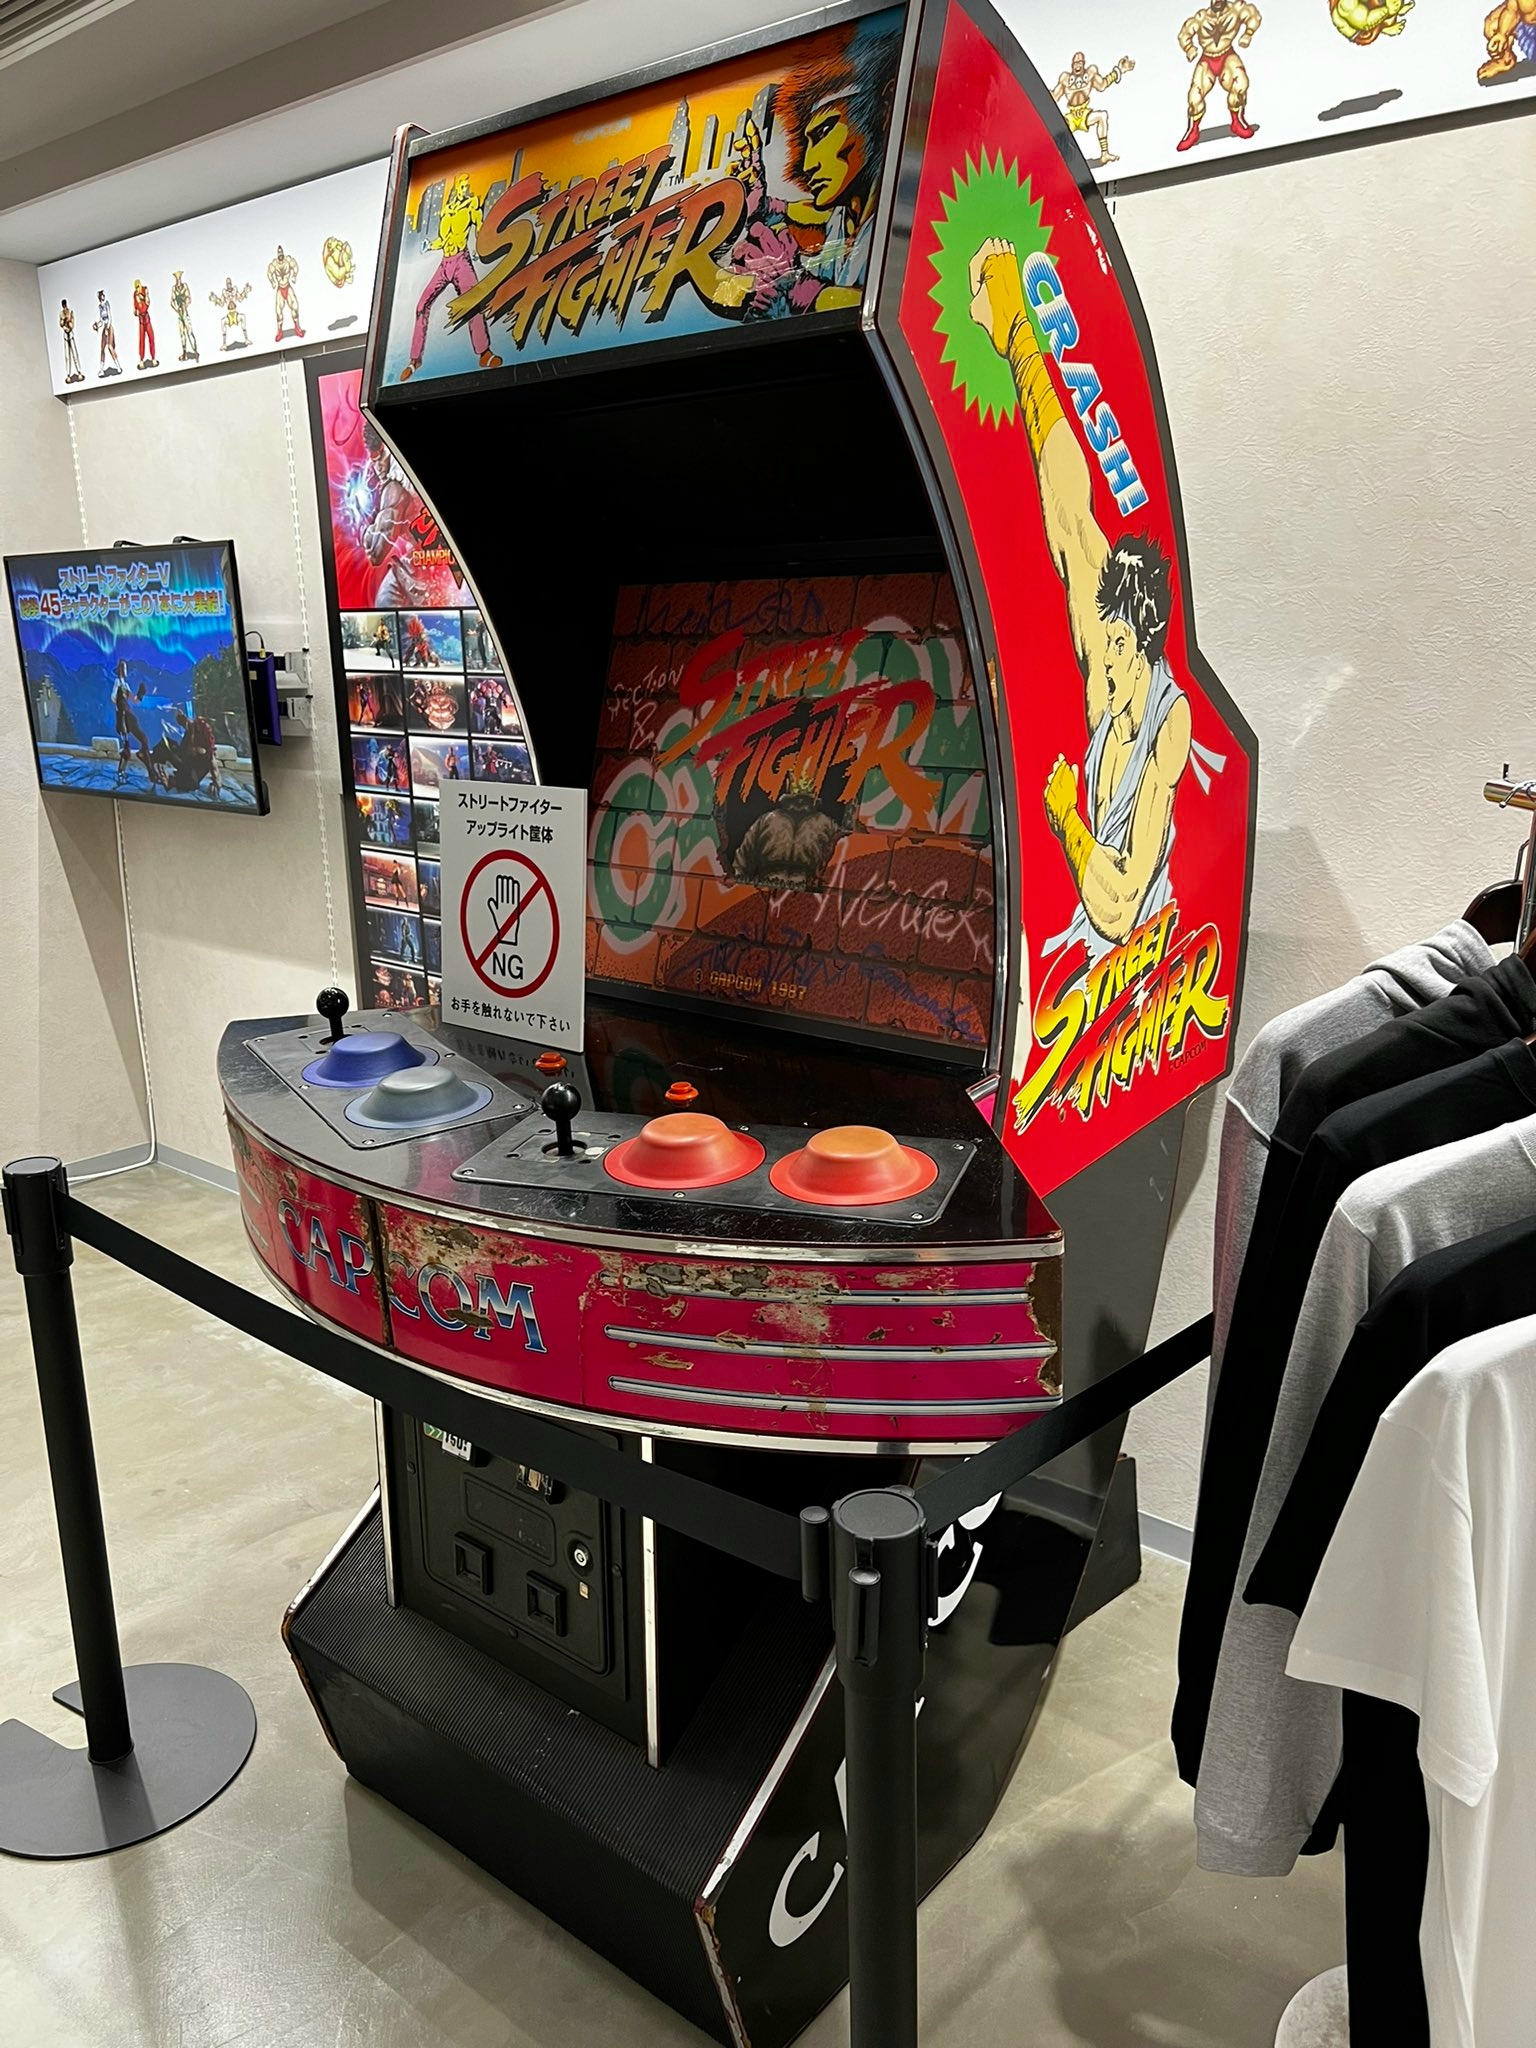
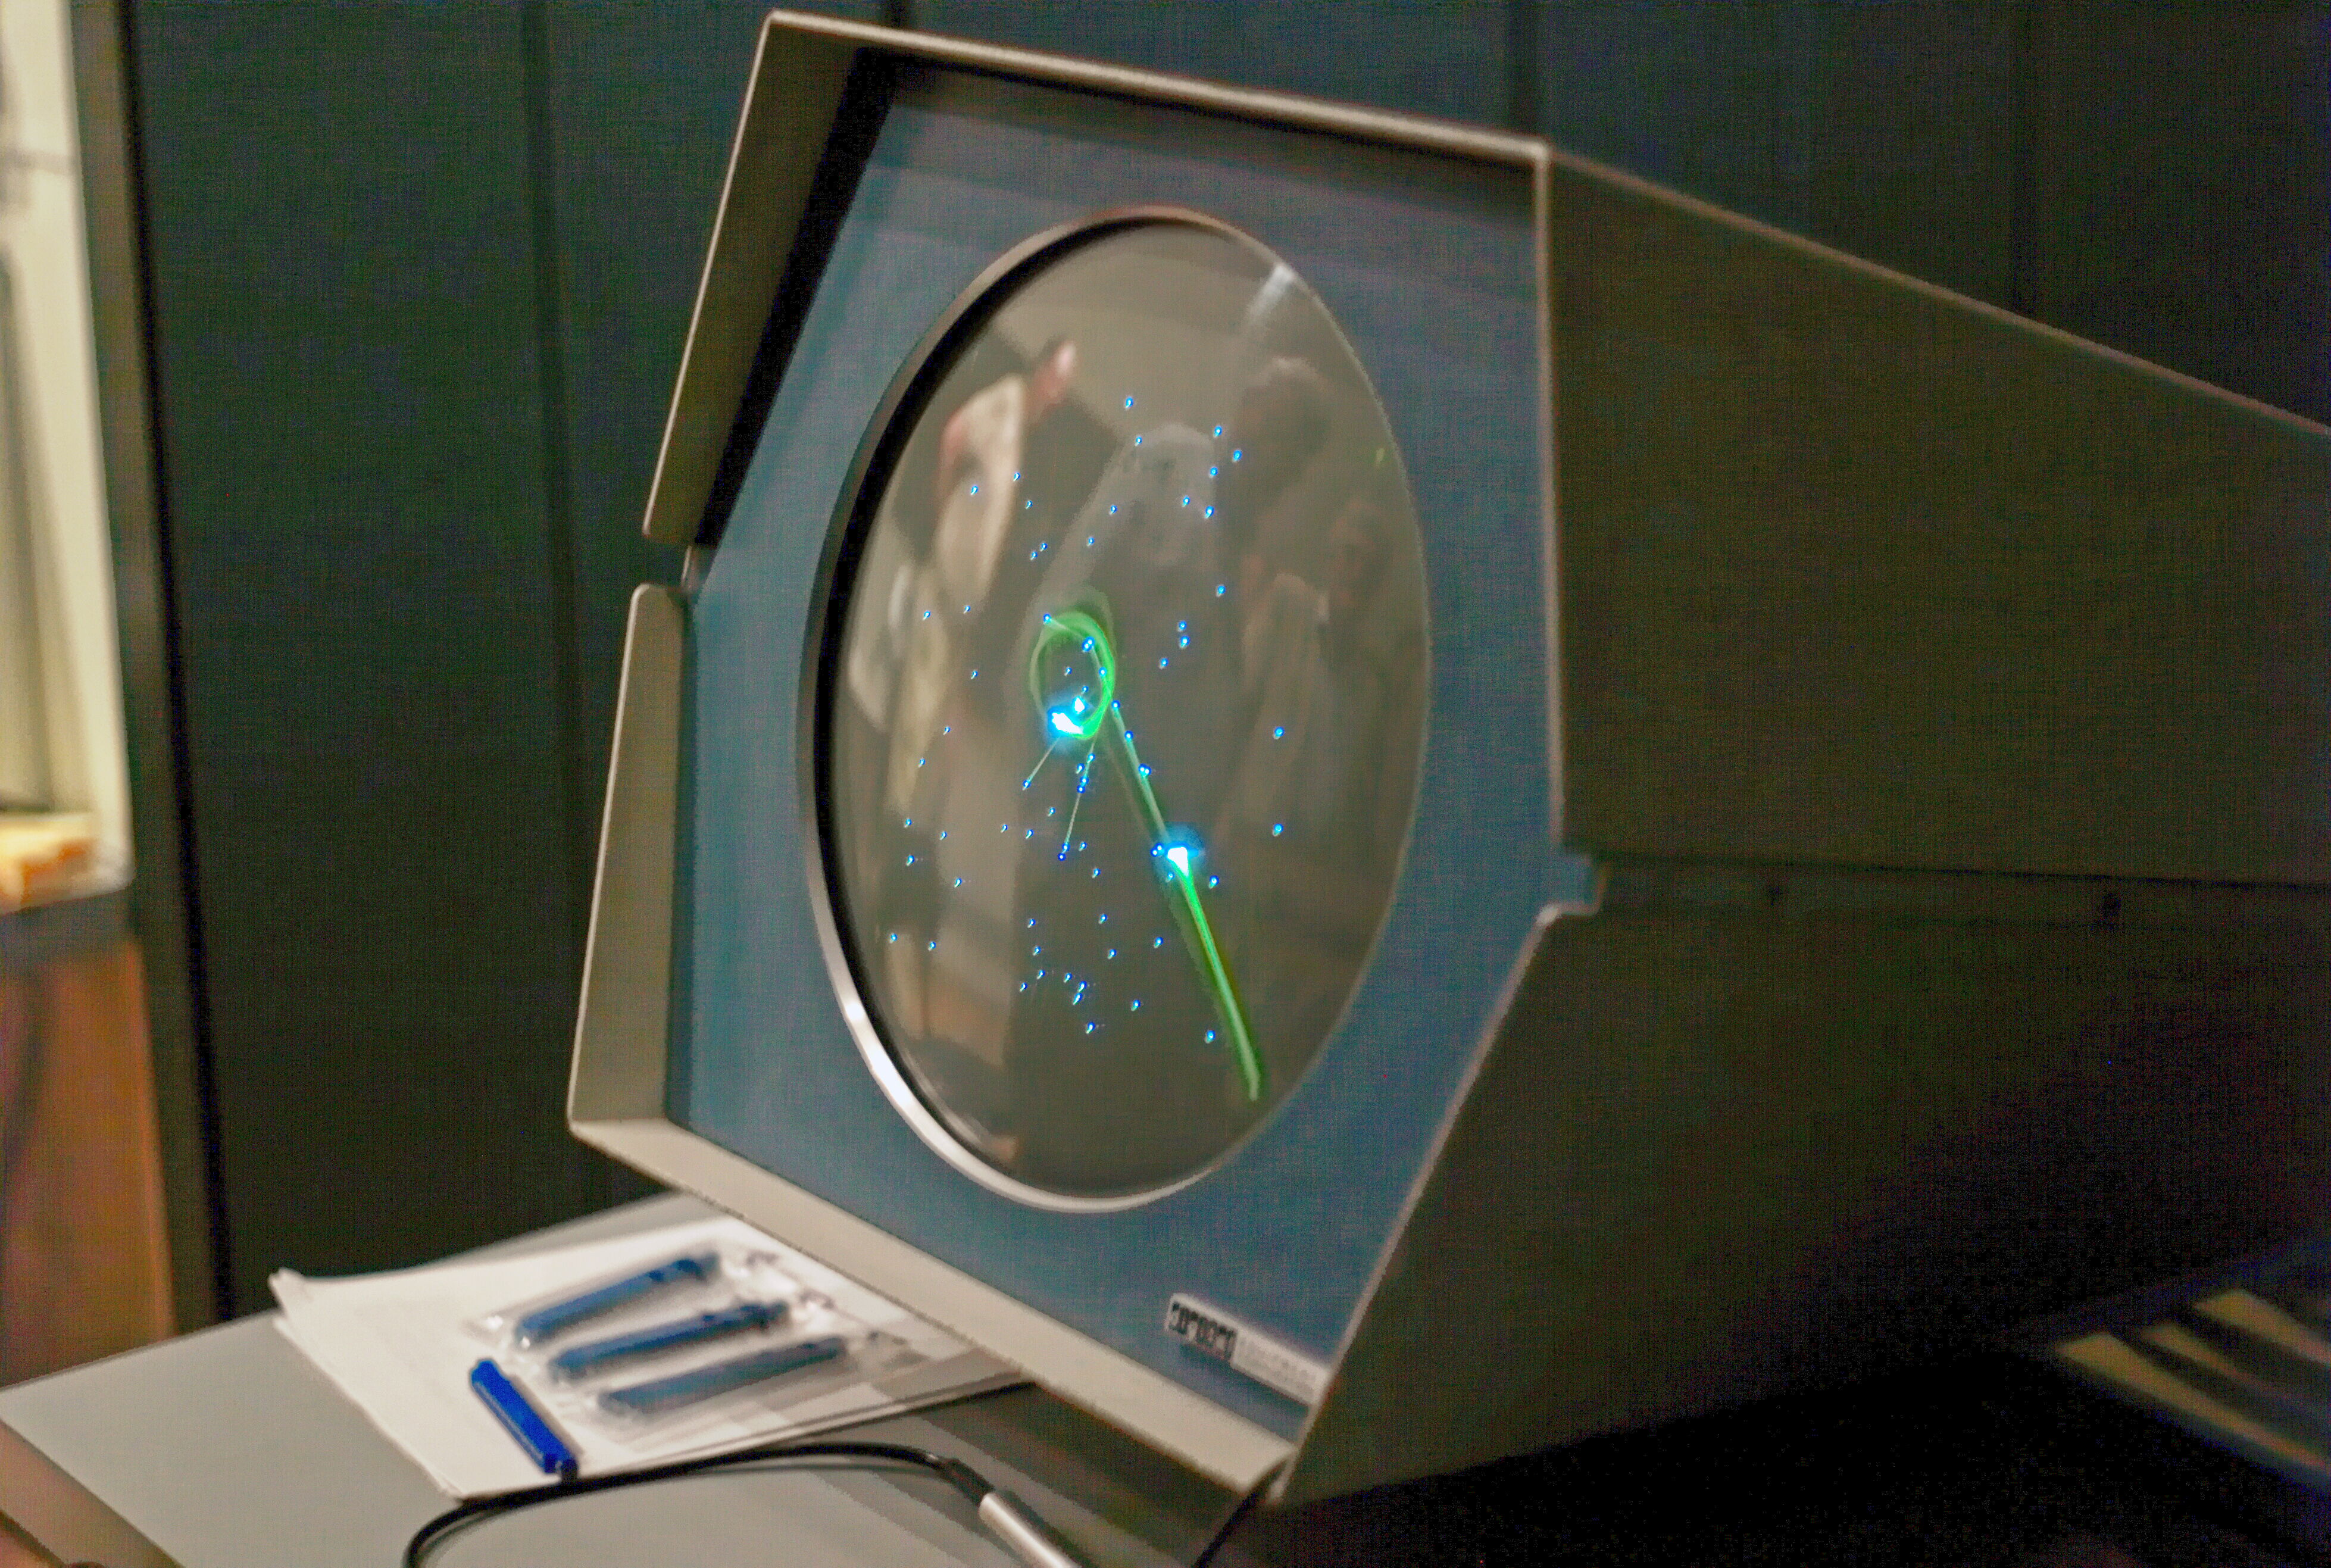
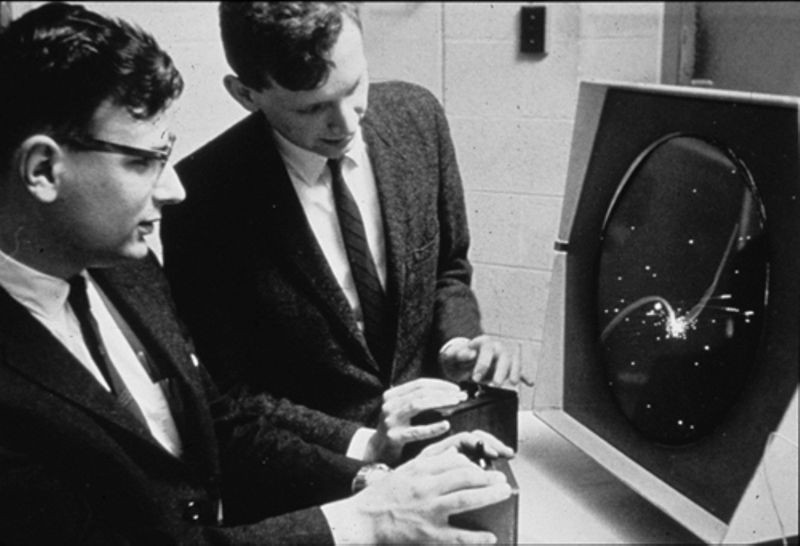
未来可能会有VR/AR?
甚至完全沉浸式VRMMORPG?
刀剑神域 · Link Start
会将游戏设计得更好玩,
积累口碑
会想方设法让玩家“难受”,
从而“氪金”
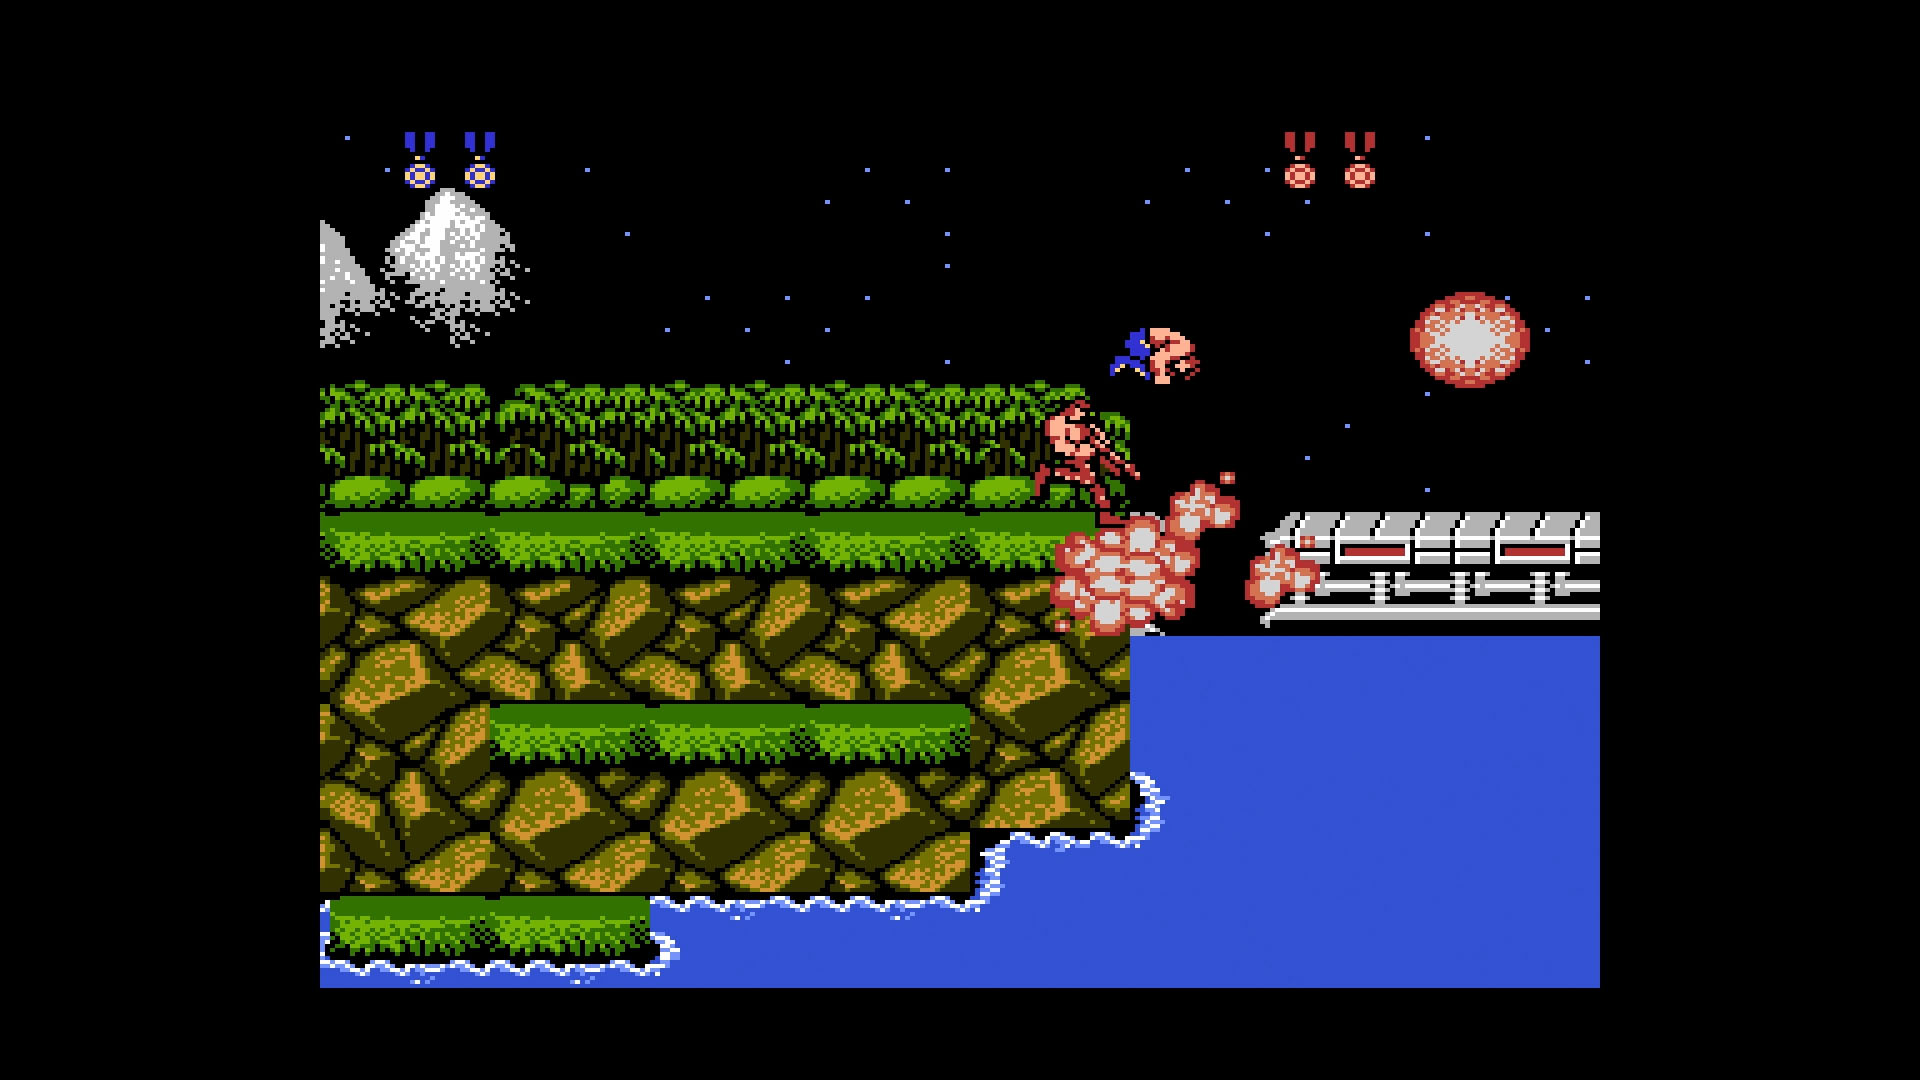
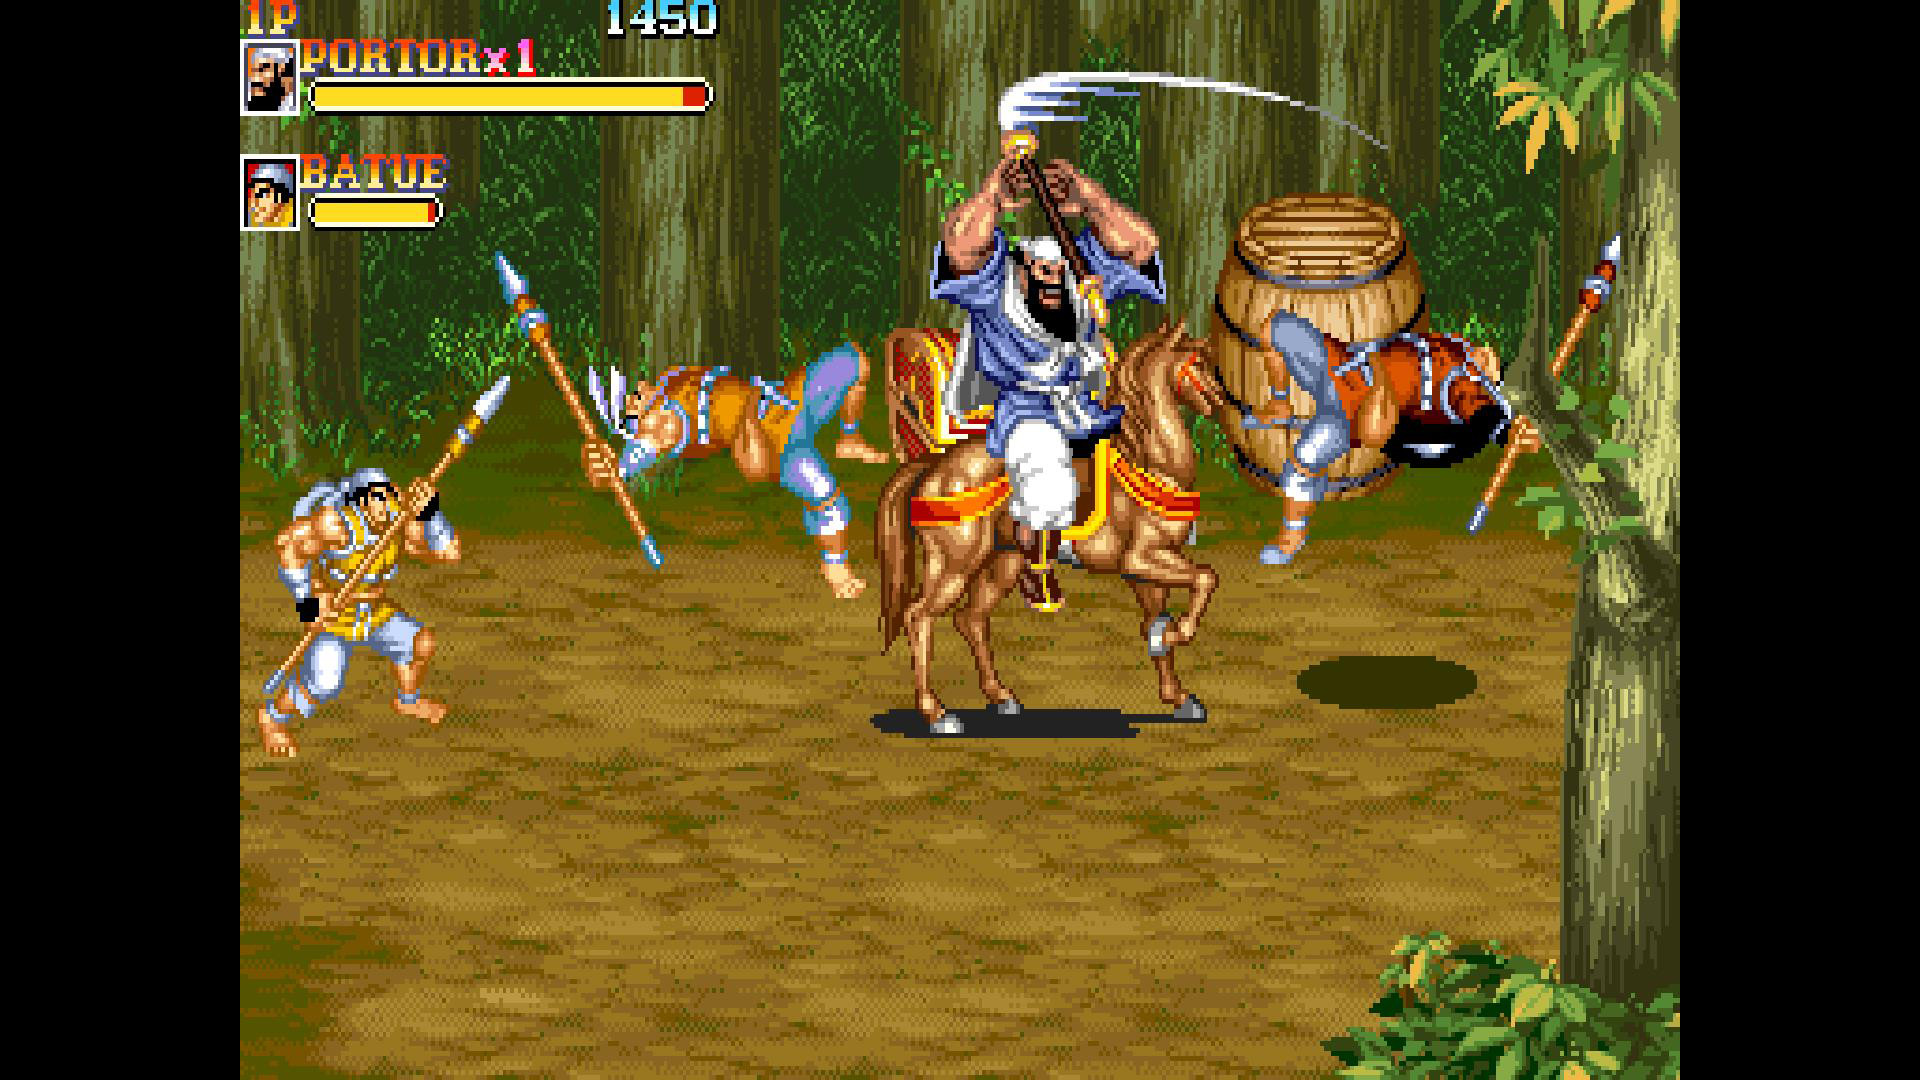
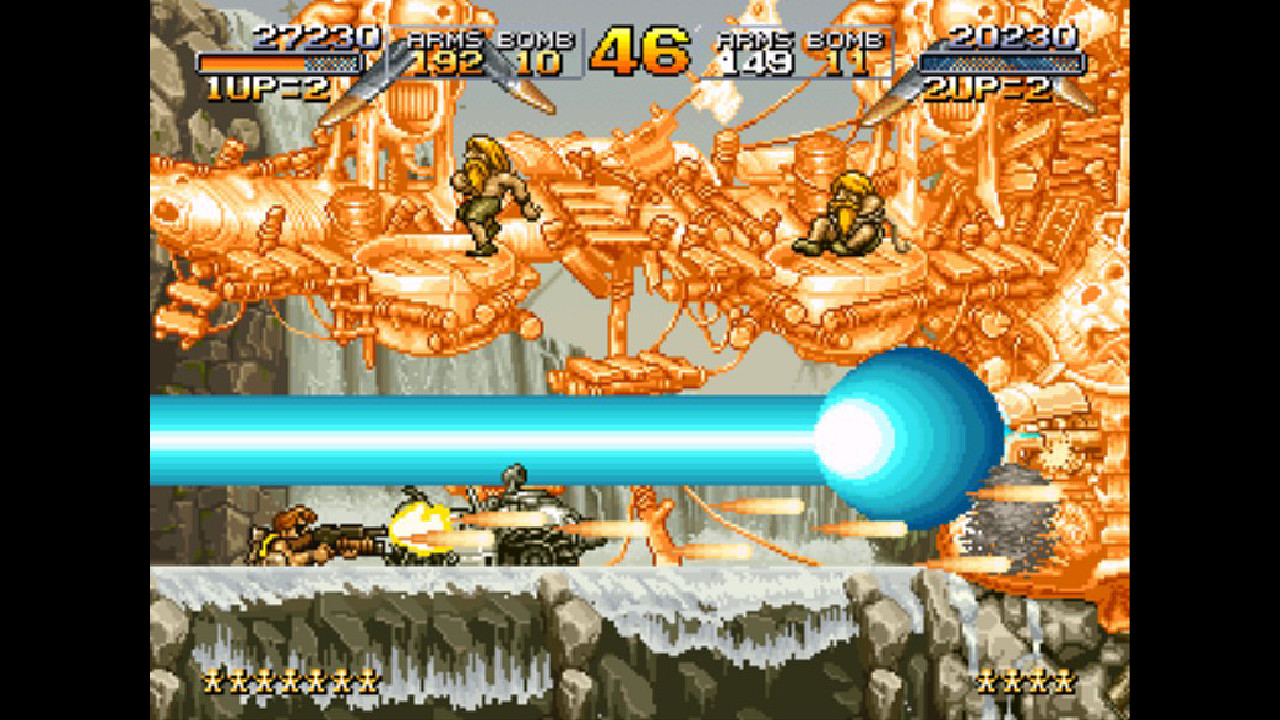
街机游戏会大幅提高游戏难度,
让玩家投币续命
不同年代、不同平台、不同付费方式
可能完全不同!
街机用专用硬件,
一台机器=一个游戏

早期主机游戏受卡带容量限制,
也会提高难度,从而让玩家觉得
耐玩、物有所值
真实工业界的代码,也不一定优质
游戏制作方式可能迎来变革
“我想做一个游戏……”
古法数据,不需要了
未来真的还需要写代码吗?